Gemini 3.8 Flash TTS: tulis deskripsi suara, lalu skripnya
Gemini 3.8 Flash TTS adalah model suara unggulan Google, dan model pertama yang bisa Anda arahkan alih-alih memilih suara yang tersedia. Deskripsikan suara yang Anda inginkan dengan bahasa sehari-hari—petugas operator sif malam yang kelelahan, narator remaja yang ceria—lalu model ini akan membawakan skrip Anda dengan suara tersebut dalam lebih dari 130 bahasa, lengkap dengan aksen yang Anda minta. Arahkan penyampaian setiap baris, buat dialog antara dua karakter, dan jaga agar warna suara tetap konsisten selama berjam-jam audio. Kini tersedia di AI Playground milik Picsart.
- Deskripsikan suara yang Anda inginkan
- Arahkan penyampaian setiap baris
Suara yang dibuat dengan Gemini 3.8 Flash TTS
Kenali Gemini 3.8 Flash TTS, dirancang untuk karakter, bukan sekadar kejelasan
Kebanyakan generator suara AI memberi Anda daftar pilihan dan pengatur kecepatan. Gemini 3.8 Flash TTS dirancang dengan pendekatan berbeda: ini adalah model suara kreatif teratas Google, dibuat untuk arahan kreatif mendalam dan desain karakter, dan dimulai dari deskripsi, bukan menu tarik-turun. Dari 30 suara orisinal Google, tersedia pustaka berisi lebih dari 2.000 suara siap produksi. Anda juga bisa menulis deskripsi untuk membuat suara baru yang sama sekali belum ada di pustaka tersebut. Model ini menempati posisi pertama dalam Voice Design Benchmark dari Hume AI, yang memang dirancang untuk menguji kemampuan utamanya.
Rancang suara dengan satu kalimat dalam lebih dari 130 bahasa
Tulis suara yang ingin Anda dengar, lalu model ini akan membuatnya: usia, tekstur, energi, dan aksen yang diinginkan. Minta bahasa Spanyol Meksiko, bukan bahasa Spanyol umum; bahasa Prancis Quebec, bukan bahasa Prancis Paris; aksen Skotlandia atau AS Selatan, bukan aksen netral yang datar. Model ini mendukung lebih dari 130 bahasa dan secara otomatis mengenali bahasa yang Anda tulis, sehingga skrip tidak perlu diberi tag atau ditentukan bahasanya—dengan hasil terbaik dalam bahasa Jepang, Portugis Brasil, Vietnam, Arab Standar Modern, Spanyol Meksiko, dan Hindi. Deskripsi yang sama akan menghasilkan karakter yang sama setiap kali, sehingga suara bisa digunakan kembali untuk satu serial, bukan hanya untuk sekali pakai.
- Bentuk aksen daerah
Beri arahan kepada suara AI seperti Anda mengarahkan aktor
Pembacaan yang datar membuat suara sintetis mudah dikenali. Di sini, Anda bisa mengarahkan setiap baris secara terpisah: buat baris ini terdengar lelah, sampaikan baris itu seperti lelucon, lalu ucapkan baris berikutnya hampir seperti berbisik. Sisipkan tawa, helaan napas, keterkejutan, atau tarikan napas yang tertahan tepat di bagian yang dibutuhkan. Tambahkan suara yang membuat percakapan terasa nyata—gumaman setuju, suara kecil yang dibuat seseorang saat lawan bicaranya masih berbicara—dan buat dialog dua karakter yang terasa alami, dengan suara khas masing-masing sepanjang percakapan. Prosesnya lebih mirip mengarahkan pembacaan daripada sekadar membuatnya, sehingga hasilnya tak lagi terdengar seperti teks yang diubah menjadi suara.
Suara yang tetap konsisten sepanjang rekaman panjang
Rekaman panjang sering kali menjadi kendala bagi kebanyakan model suara: warna suara berubah-ubah, suasana ruang di sekitar pembicara berganti, dan suara di bab sembilan tidak sama dengan bab pertama. Gemini 3.8 Flash TTS menjaga kualitas suara, tempo, dan karakter suara tetap konsisten selama berjam-jam, dengan volume dan suasana akustik yang sama dari baris pertama hingga terakhir. Audio dihasilkan dalam format WAV standar dan siap dimasukkan ke proyek penyuntingan. Perlu memproses audio dalam jumlah besar, misalnya untuk sulih suara atau agen suara? Gemini 3.8 Flash-Lite TTS adalah model dalam keluarga yang sama, dioptimalkan untuk pemrosesan volume tinggi. Di Picsart, keduanya tersedia bersama lebih dari 150 model, sehingga Anda bisa membuat suara untuk satu skrip di sini, lalu beralih model untuk skrip berikutnya.
- Pertahankan satu suara dalam rekaman panjang

Hal yang bisa Anda buat dengan Gemini 3.8 Flash TTS
Buku audio dan narasi panjang
Rekam audio selama berjam-jam dengan suara yang konsisten tanpa perubahan warna suara antarsesi, dan arahkan narator untuk setiap bab.
Pertanyaan umum tentang Gemini 3.8 Flash TTS
Ini adalah model teks-ke-suara unggulan Google, dirilis pada September 2026 dan dibuat untuk arahan kreatif serta desain karakter. Alih-alih memilih dari daftar suara yang sudah ditentukan, Anda cukup mendeskripsikan suara yang diinginkan. Model ini akan membawakan skrip Anda dengan suara tersebut dalam lebih dari 130 bahasa, dengan arahan yang diterapkan untuk setiap baris.
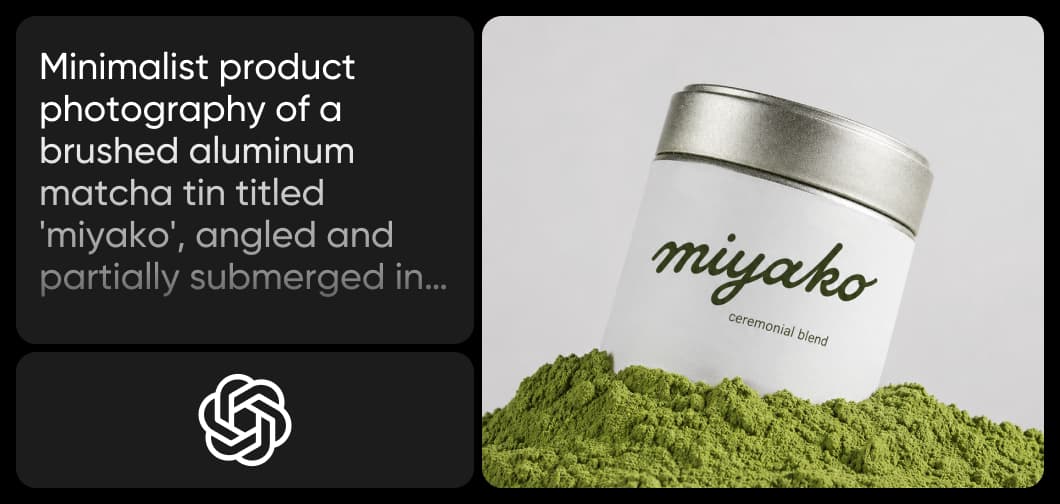
Buat visual AI dengan GPT Image 2.5
Pro
Most popularAI tools for everyday creative work.
Ultra
Most powerfulHeavy AI usage for creators & teams.
Buat visual AI dengan GPT Image 2.5
Pro
Most popularAI tools for everyday creative work.
Ultra
Most powerfulHeavy AI usage for creators & teams.