Gemini 3.8 Flash TTS: ออกแบบเสียง แล้วเขียนสคริปต์
Gemini 3.8 Flash TTS คือโมเดลเสียงระดับเรือธงของ Google และเป็นโมเดลแรกที่คุณกำกับได้ แทนที่จะเลือกเสียงจากรายการ เพียงอธิบายเสียงที่ต้องการด้วยภาษาทั่วไป เช่น ผู้ควบคุมการสื่อสารกะดึกที่อ่อนล้า หรือนักเล่าเรื่องวัยรุ่นที่สดใส แล้วโมเดลจะพากย์สคริปต์ของคุณด้วยเสียงนั้นได้มากกว่า 130 ภาษา พร้อมสำเนียงตามที่คุณระบุ กำกับการถ่ายทอดทีละบรรทัด จัดฉากบทสนทนาระหว่างตัวละครสองคน และคงน้ำเสียงเดิมให้สม่ำเสมอตลอดไฟล์เสียงหลายชั่วโมง ใช้งานได้แล้วใน AI Playground ของ Picsart
- อธิบายเสียงที่ต้องการ
- กำกับการถ่ายทอดทีละบรรทัด
เสียงที่สร้างด้วย Gemini 3.8 Flash TTS
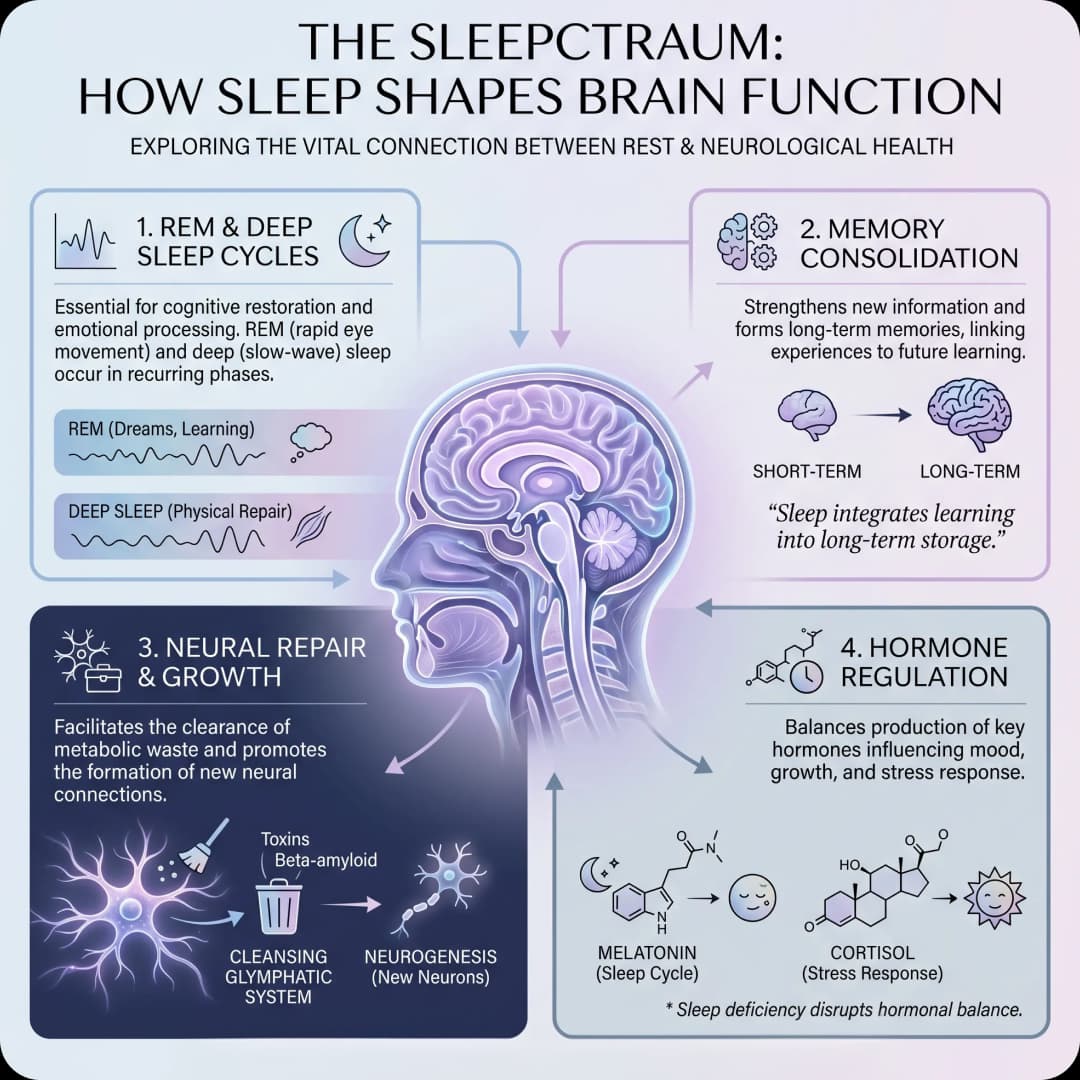
รู้จัก Gemini 3.8 Flash TTS ที่สร้างมาเพื่อถ่ายทอดคาแรกเตอร์ ไม่ใช่แค่ความชัดเจน
เครื่องมือสร้างเสียง AI ส่วนใหญ่ให้คุณเลือกเสียงจากรายการและปรับความเร็วด้วยแถบเลื่อน แต่ Gemini 3.8 Flash TTS ออกแบบมาในแนวทางที่ต่างออกไป โดยเป็นโมเดลเสียงสร้างสรรค์ระดับสูงสุดของ Google ที่สร้างมาเพื่อการกำกับเชิงสร้างสรรค์อย่างละเอียดและการออกแบบคาแรกเตอร์ เริ่มจากคำบรรยายแทนเมนูแบบเลื่อนเลือก เสียงต้นแบบ 30 แบบของ Google ขยายเป็นคลังเสียงพร้อมใช้งานจริงกว่า 2,000 แบบ และคุณยังเขียนคำบรรยายเพื่อสร้างเสียงใหม่ที่ไม่มีอยู่ในคลังได้อีกด้วย โมเดลนี้คว้าอันดับหนึ่งในการทดสอบ Voice Design Benchmark ของ Hume AI ซึ่งตรงกับสิ่งที่โมเดลนี้สร้างมาเพื่อทำโดยเฉพาะ
ออกแบบเสียงด้วยประโยคเดียว ในกว่า 130 ภาษา
เขียนสิ่งที่อยากได้ยิน แล้วโมเดลจะสร้างเสียงให้ ทั้งอายุ ลักษณะเสียง พลัง และสำเนียงที่ต้องการ เลือกสำเนียงสเปนเม็กซิกันแทนภาษาสเปนทั่วไป หรือฝรั่งเศสแบบควิเบกแทนแบบปารีส จะเป็นสำเนียงสกอตหรืออเมริกันใต้แทนเสียงกลางที่ฟังดูราบเรียบก็ได้ โมเดลรองรับมากกว่า 130 ภาษาและตรวจจับภาษาในข้อความให้เอง คุณจึงไม่ต้องติดแท็กหรือระบุภาษา โดยให้ผลลัพธ์โดดเด่นเป็นพิเศษในภาษาญี่ปุ่น โปรตุเกสบราซิล เวียดนาม อาหรับมาตรฐานสมัยใหม่ สเปนเม็กซิกัน และฮินดี คำอธิบายเดิมจะสร้างคาแรกเตอร์เสียงเดิมได้ทุกครั้ง ทำให้คุณนำเสียงไปใช้ซ้ำในซีรีส์ได้ ไม่ใช่แค่สร้างครั้งเดียว
- ปรับแต่งสำเนียงท้องถิ่น
กำกับเสียง AI ได้เหมือนกำกับนักแสดง
การอ่านที่ราบเรียบไร้อารมณ์คือสิ่งที่ทำให้เสียงสังเคราะห์ฟังออกว่าปลอม ที่นี่คุณกำกับแต่ละบรรทัดได้แยกกัน ให้ประโยคนี้ฟังดูเหนื่อย อีกประโยคลงท้ายเป็นมุกตลก และประโยคถัดไปเบาลงจนเกือบกระซิบ ใส่เสียงหัวเราะ ถอนหายใจ อุทาน หรือสูดหายใจสะดุดตรงจังหวะที่การแสดงต้องการ เพิ่มเสียงที่ทำให้บทสนทนาสมจริง ทั้งเสียงพึมพำตอบรับหรือเสียงเล็ก ๆ ที่ใครบางคนเปล่งออกมาขณะที่อีกคนยังพูดไม่จบ และจัดฉากบทสนทนาระหว่างตัวละครสองคนอย่างเป็นธรรมชาติ โดยให้แต่ละคนคงเสียงของตัวเองตลอดการโต้ตอบ วิธีนี้ใกล้เคียงกับการกำกับการอ่านบทมากกว่าการสร้างเสียง จึงทำให้ผลลัพธ์ไม่ฟังเหมือนข้อความที่ถูกแปลงเป็นเสียงพูด
เสียงคงเดิมตลอดการบันทึกที่ยาวนาน
งานเสียงยาวคือจุดที่โมเดลเสียงส่วนใหญ่มักมีปัญหา น้ำเสียงเปลี่ยนไป สภาพเสียงรอบผู้พูดไม่เหมือนเดิม บทที่เก้าไม่ตรงกับบทแรก Gemini 3.8 Flash TTS คงคุณภาพเสียง จังหวะ และน้ำเสียงของคาแรกเตอร์ให้สม่ำเสมอตลอดหลายชั่วโมง โดยรักษาระดับเสียงและบรรยากาศเสียงเดิมตั้งแต่บรรทัดแรกจนถึงบรรทัดสุดท้าย ไฟล์เสียงมาในรูปแบบ WAV มาตรฐาน พร้อมนำไปตัดต่อ หากต้องทำงานปริมาณมาก เช่น พากย์เสียงหรือสร้างเอเจนต์เสียง ลองใช้ Gemini 3.8 Flash-Lite TTS ซึ่งเป็นโมเดลในตระกูลเดียวกันที่ปรับแต่งมาเพื่อรองรับงานปริมาณมาก ใน Picsart มีโมเดลให้เลือกใช้กว่า 150 แบบ คุณจึงสร้างเสียงให้สคริปต์นี้ได้ที่นี่ แล้วเปลี่ยนโมเดลสำหรับสคริปต์ถัดไป
- คงเสียงเดิมตลอดการบันทึกยาว

สร้างอะไรได้บ้างด้วย Gemini 3.8 Flash TTS
หนังสือเสียงและเสียงบรรยายยาว
บันทึกเสียงหลายชั่วโมงด้วยน้ำเสียงเดิมที่สม่ำเสมอ ไม่เปลี่ยนไปในแต่ละเซสชัน พร้อมกำกับผู้บรรยายแยกเป็นรายบท
คำถามที่พบบ่อยเกี่ยวกับ Gemini 3.8 Flash TTS
โมเดลแปลงข้อความเป็นเสียงระดับเรือธงของ Google เปิดตัวในเดือนกันยายน 2026 และสร้างมาเพื่อการกำกับเชิงสร้างสรรค์และการออกแบบคาแรกเตอร์ แทนที่จะเลือกเสียงจากรายการที่กำหนดไว้ คุณสามารถอธิบายเสียงที่ต้องการ แล้วให้โมเดลพากย์สคริปต์ด้วยเสียงนั้นได้มากกว่า 130 ภาษา พร้อมกำกับเสียงทีละบรรทัด
สร้างภาพ AI ด้วย GPT Image 2.5
Pro
Most popularAI tools for everyday creative work.
Ultra
Most powerfulHeavy AI usage for creators & teams.
สร้างภาพ AI ด้วย GPT Image 2.5
Pro
Most popularAI tools for everyday creative work.
Ultra
Most powerfulHeavy AI usage for creators & teams.