Kling 2.6: pembuatan video AI dengan audio native
Kling 2.6 adalah model video AI yang matang dan model pertama dari Kling yang menghasilkan audio native. Model ini menghasilkan gambar dan suaranya sekaligus dalam satu proses, sehingga klip langsung selesai—dengan suara, efek, dan suasana yang sudah menyatu, tanpa hasil render senyap atau langkah audio terpisah yang perlu ditambahkan setelahnya.
- Buat video dengan suara
- Tanpa proses audio terpisah
Video multimodal, satu model terpadu


Model Kling pertama dengan audio native
Kling V2.6 adalah model video Kling yang matang dan model pertama yang menghasilkan audio native bersama gambar. Dalam satu proses, model ini menghasilkan suara manusia—ucapan, dialog, narasi, nyanyian, dan rap—serta efek suara aksi dan suasana lingkungan. Semuanya diselaraskan dengan gerakan di layar dan bentuk gerak bibir, dengan dukungan suara dalam bahasa Inggris dan Mandarin. Suara diselaraskan dengan gerakan visual secara presisi agar terasa alami, menghasilkan audio yang lebih jernih dan kaya seperti hasil mixing di dunia nyata, serta memahami prompt dan alur cerita yang kompleks agar hasilnya tetap padu. Atur pengambilan gambar dengan Motion Control, lalu render dalam Standard untuk draf HD yang cepat atau Pro untuk hasil akhir Full HD.
Adegan yang hadir dengan suaranya sendiri
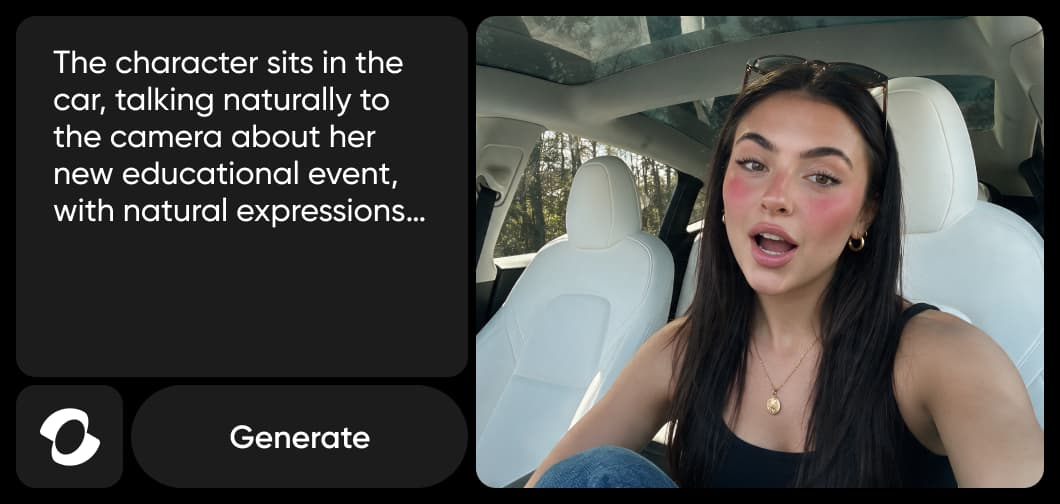
Monolog tunggal
Satu pembicara menyampaikan dialog langsung ke kamera, dengan suara alami dan gerak bibir yang selaras.
Gunakan model Kling terbaru di Picsart
Buat konten dengan model Kling terbaru di AI Playground Picsart, tempat satu prompt dapat dijalankan dengan lebih dari 150 model. Pilih model Kling terbaru di pemilih model untuk menambahkan langkah video ke alur kerja, atau gunakan di AI Video Generator untuk membuat klip dari prompt—di web, desktop, CLI, MCP, REST API, atau SDK, tanpa API key pihak ketiga atau langganan terpisah. Atur Motion Control, panduan, dan mode rendering di pengaturan sebelum mulai membuat.
Sinkronisasi, kualitas suara, dan pemahaman
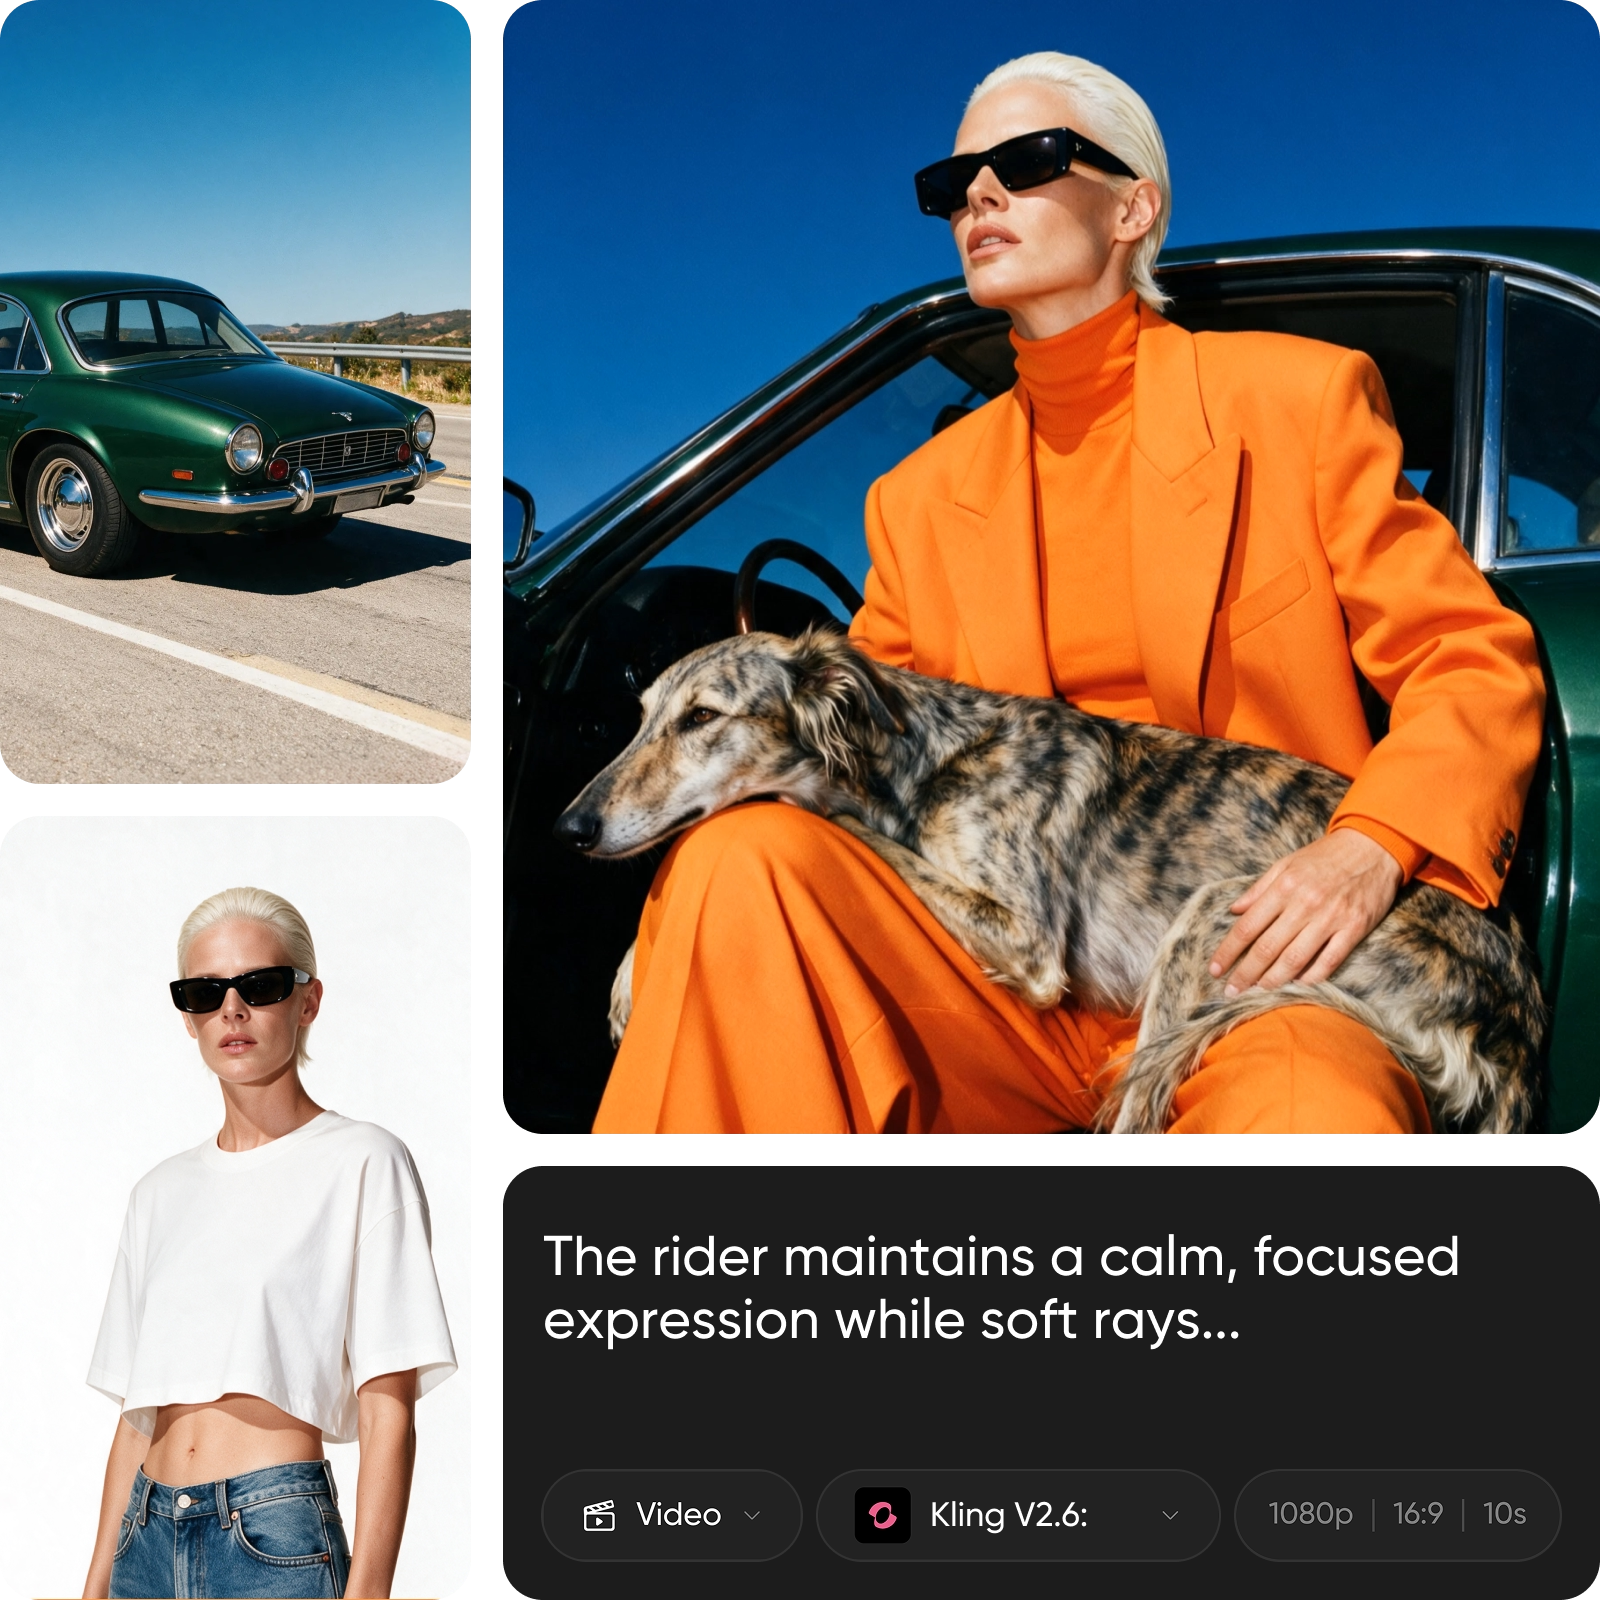
Ada 3 hal yang membedakan Kling V2.6. Audio dan visualnya selalu selaras—ucapan, suara sekitar, dan aksi di layar memiliki ritme yang sama, sehingga tidak terasa seperti ditambahkan belakangan. Suaranya juga lebih kaya dan jernih, dengan lapisan seperti hasil mixing di dunia nyata yang cocok untuk kebutuhan profesional. Selain itu, model ini benar-benar memahami brief dan mengikuti prompt terperinci serta alur cerita yang rumit agar hasilnya tetap koheren dari bingkai pertama hingga terakhir.
- Selaraskan ucapan dan efek suara
Hidupkan gambar diam dengan suara
Kling V2.6 tidak hanya memulai dari prompt. Berikan gambar diam atau sebaris teks, lalu model ini akan mengubahnya menjadi konten audiovisual—menambahkan gerakan dan soundtrack yang sesuai, lengkap dengan suara, efek, dan suasana. Ini cara tercepat untuk mengubah gambar yang sudah ada menjadi video dinamis yang kaya dan bersuara.
- Gerakkan gambar diam
Pahami pilihan model video
Pelajari cara membandingkan model video dan memilih hasil yang diinginkan.
Jelajahi model lain seperti Kling 2.6
Bandingkan Kling V2.6 dengan model video dan audio lainnya untuk kebutuhan gerakan, suara, dan kampanye.
FAQ Motion Control Kling 3.0 Omni
Kling V2.6 adalah model video AI yang matang dan model pertama dari Kling dengan audio native—menghasilkan video beserta suara yang tersinkronisasi dalam satu proses, dengan Motion Control dan pilihan rendering Standard atau Pro.
Buat visual AI dengan Kling 3.0 Omni
Pro
Most popularAI tools for everyday creative work.
Ultra
Most powerfulHeavy AI usage for creators & teams.